K10模型向左,Skill 向右
模型人人都能买到,能力涨上来的部分不属于你;Skill 越来越个人,长在你的资料、判断和验收里。
一夜归零的核心技术
2024 年上半年,我和团队在做一个微信群总结机器人。那时候模型的上下文窗口只有 8K,群聊记录塞不进去。我写了一个 K 型压缩算法:首尾多保留,中间压缩,递归压到 6K 以内。这是我们的核心技术。
几个月后,模型的上下文窗口从 8K 涨到了 200K。我的核心技术一夜之间归零。
模型往左
模型这一侧,所有人都能买到同一个。它的能力一直在涨,你今天为它的短板写的补丁,很可能被下一个版本顺手抹平。
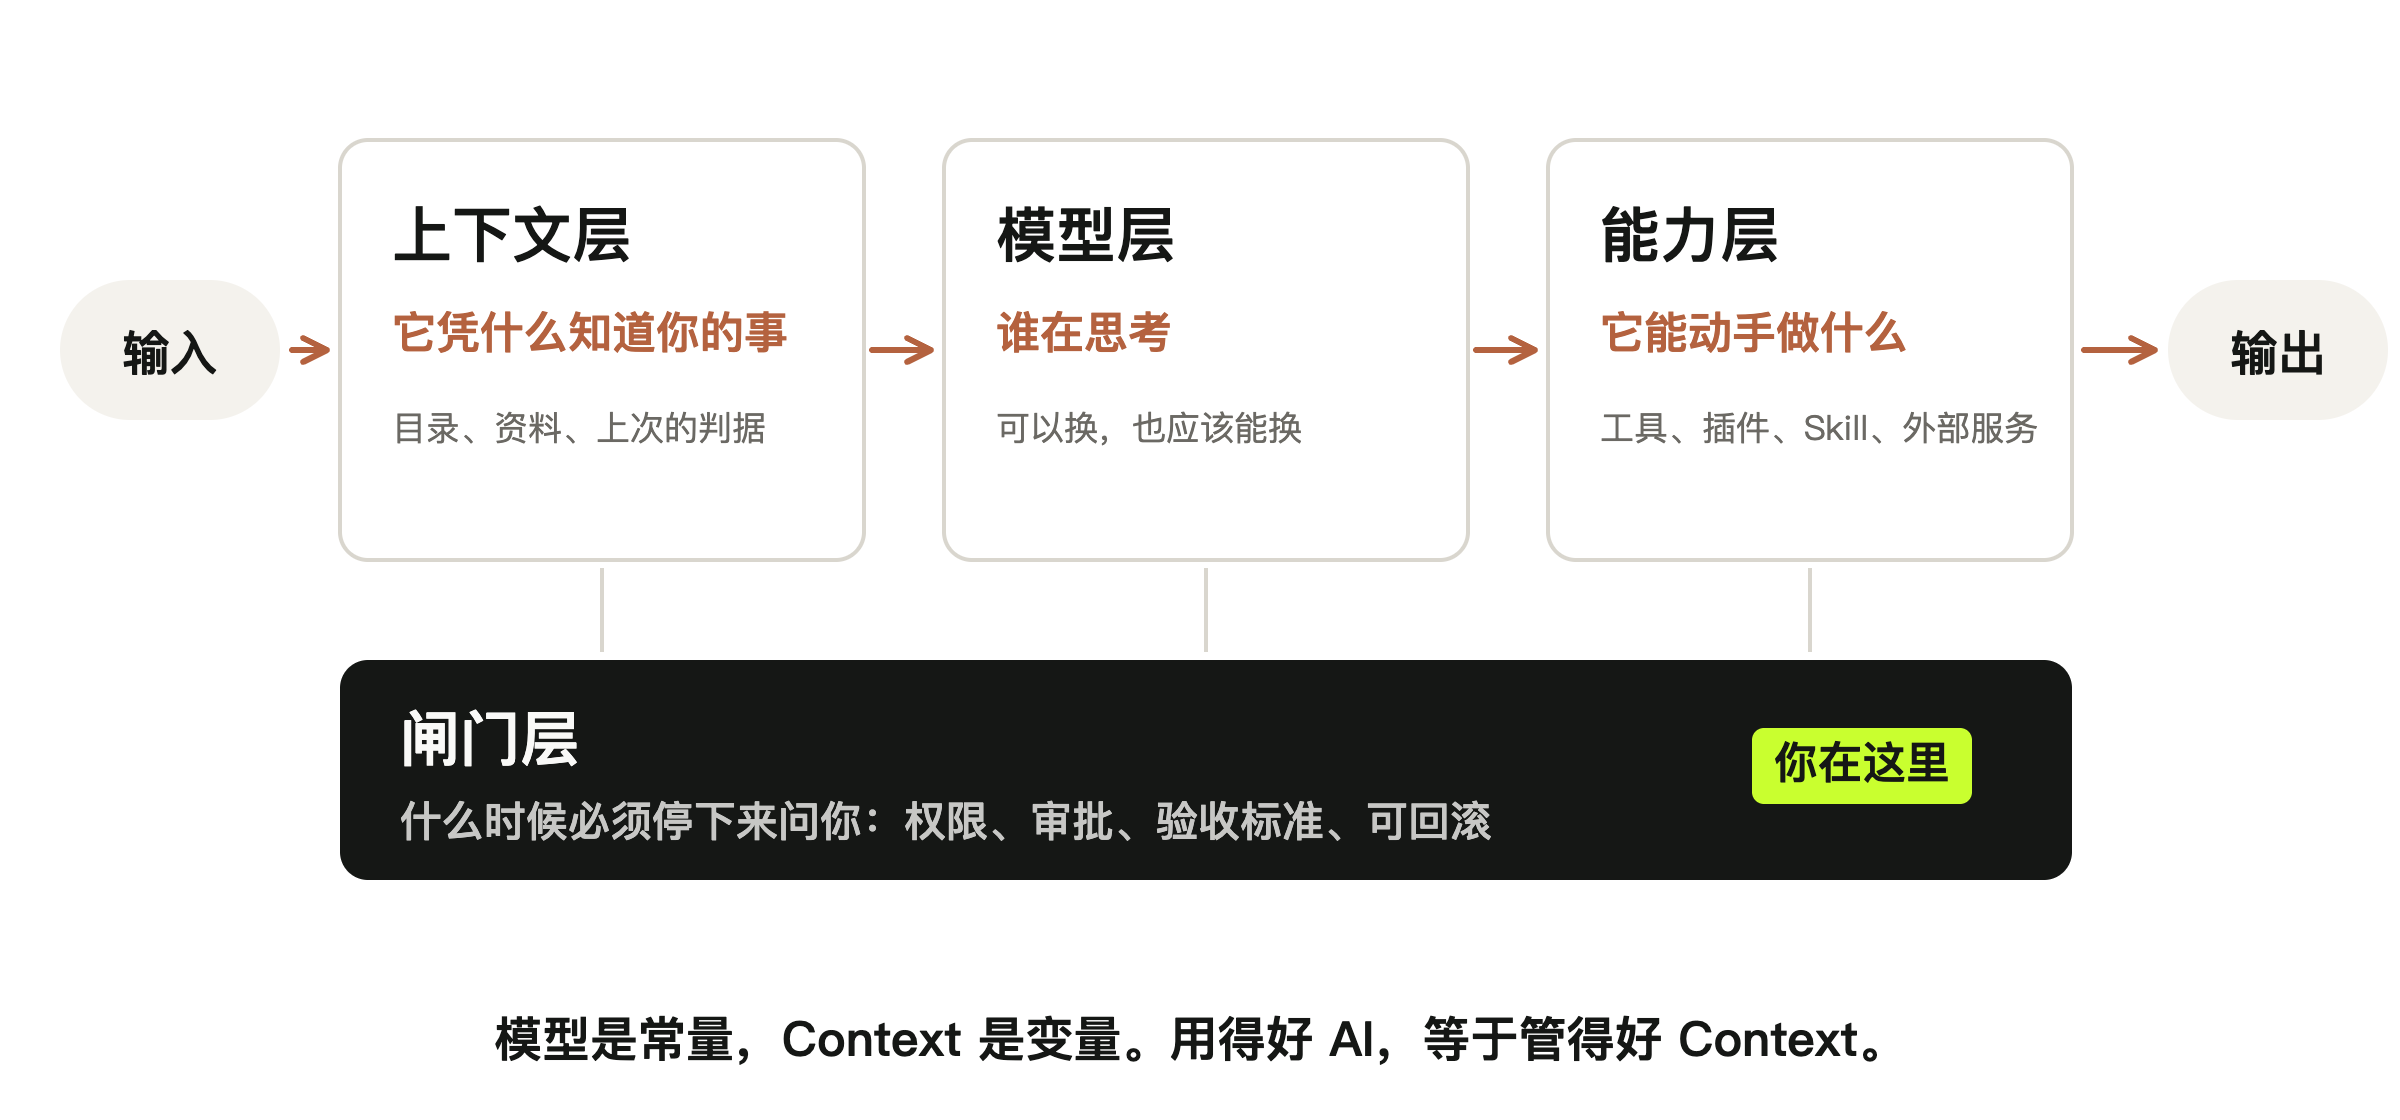
模型是常量,Context 是变量。用得好 AI,等于管得好 Context。
我常把一台 Agent 工作台拆成四层:上下文层、模型层、能力层、闸门层。模型层可以换,也应该能换。大部分人只在这一层上花心思,哪个最强,哪个最便宜;真正拉开差距的是上下文层和闸门层,前者决定它懂不懂你,后者决定你敢不敢把事交给它。
Skill 往右
Skill 这一侧往个人的方向长。公共 Skill 面对平均用户、默认工具和通用流程,只是一个可用的起点;最好的 Skill 往往是定制的,把一个人的资料、账户、知识库、常用软件、风险偏好、审美和验收标准写了进去。我把这叫作千人千 Skill。
我自己用得最多的 Top 10,集中在提交、发布、验证和 Skill 治理,都是照着我自己的交付习惯长出来的。
高价值的部分不是人人都能下载的文件,而是一个人怎样把不可复制的工作方式变成可执行能力。
判断留下,模型就能换
外滩大会上我讲过一组视频 Skill。预处理负责把 4 小时 10 分钟的原片拆成 58 段可用素材和 18 段待复核的素材;创作负责横竖两个版本、字幕、混音和质量检查;发布负责终稿确认、双平台发布,再回到平台核对是否真的发了出去。
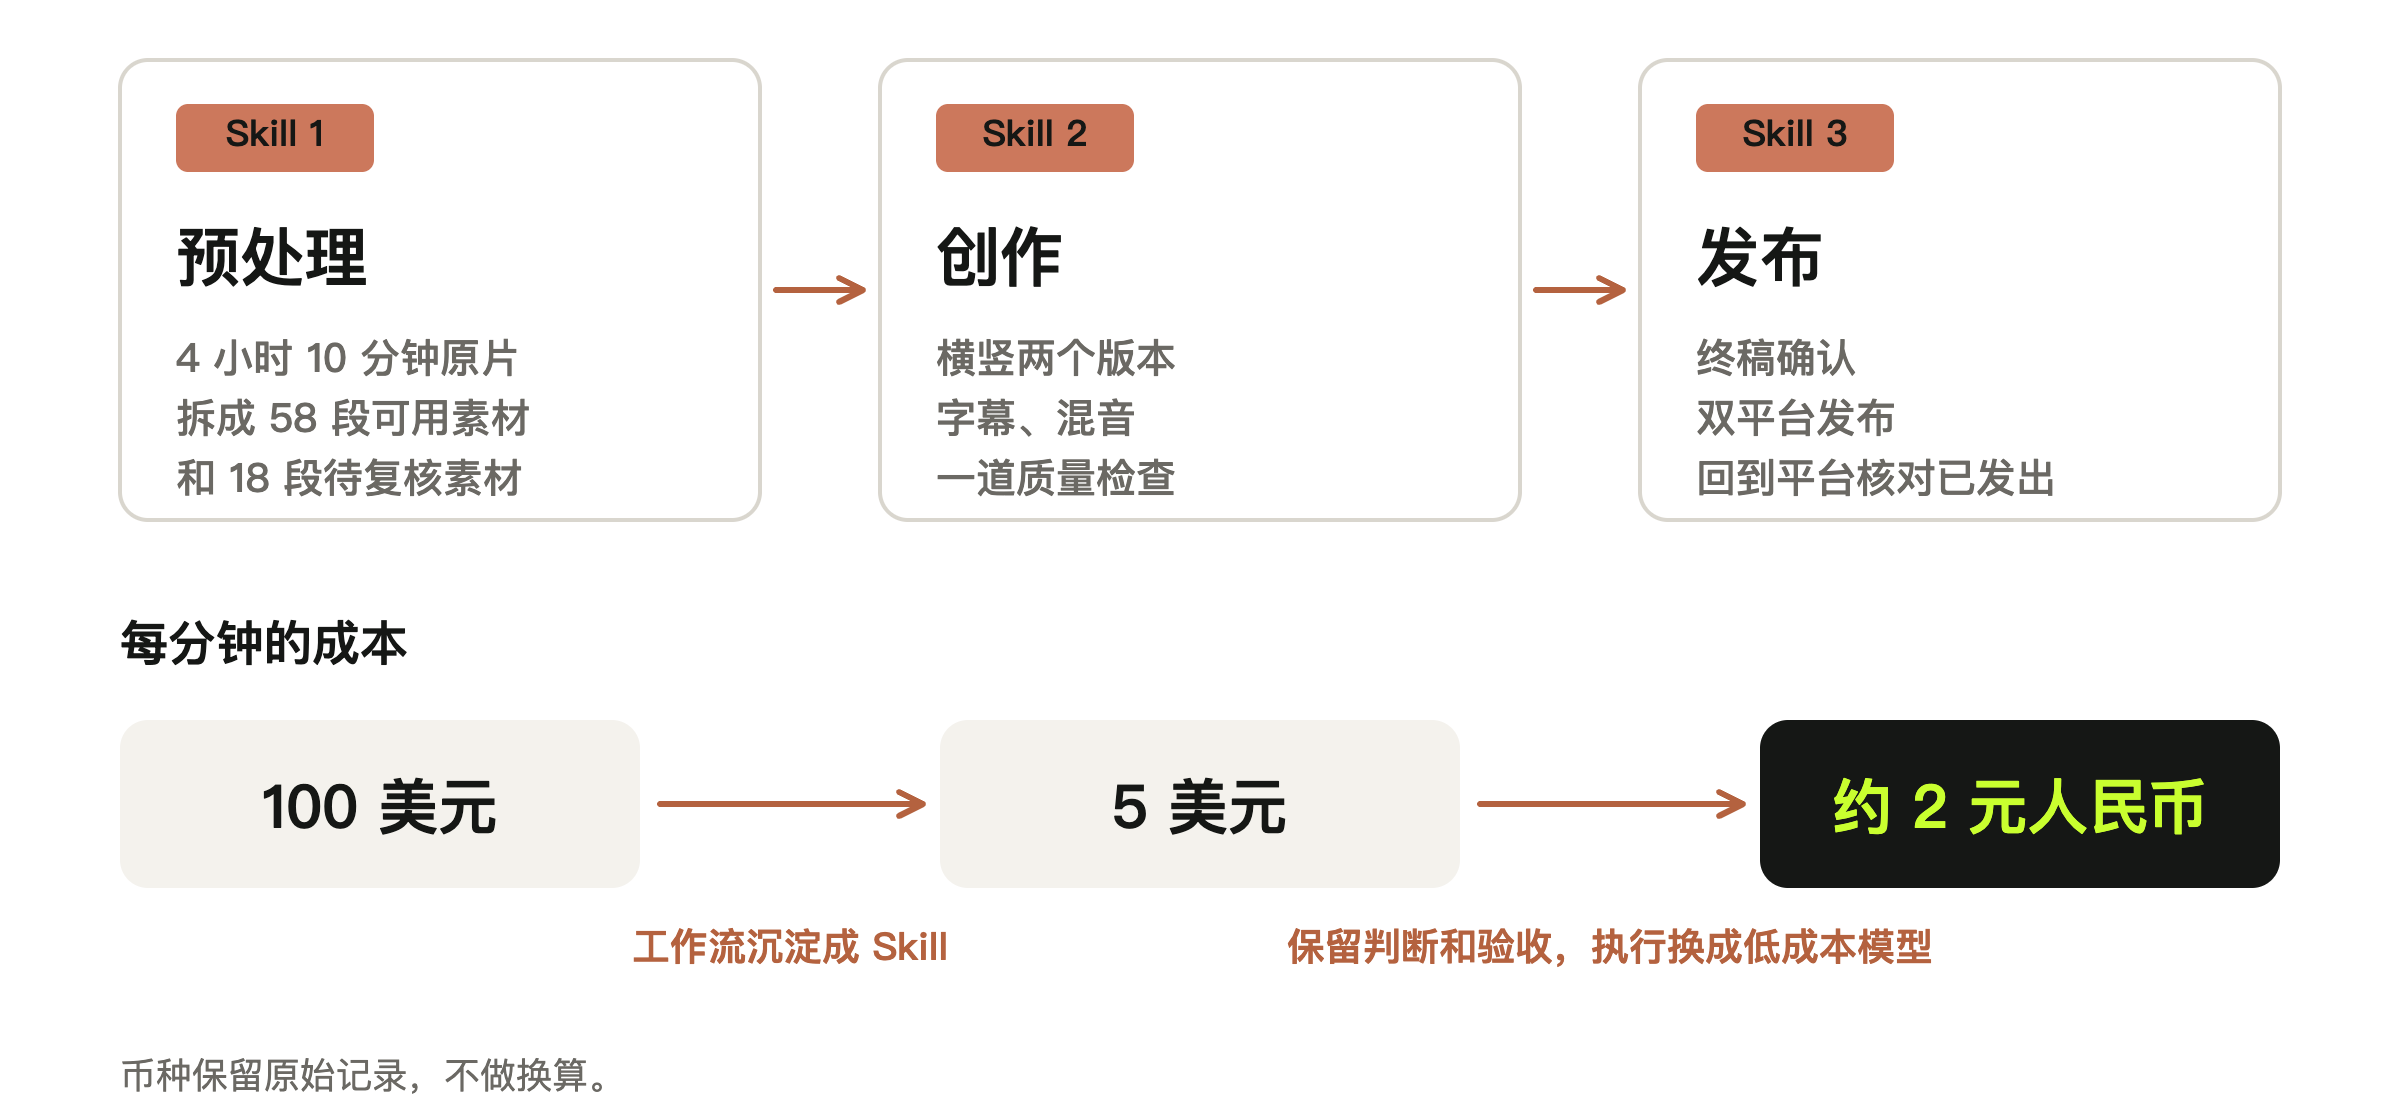
成本降了两次。第一次是把工作流沉淀成 Skill,每分钟从 100 美元降到 5 美元;第二次是保留人的判断和验收,把执行的模型换成低成本模型,降到约 2 元人民币。币种按原始记录,不做换算。
第二次降本能成立,是因为判断和验收已经写进了 Skill。 干活的模型换成便宜的,验收的标准没有跟着降。
把这件事摊开,是一条从通用到个人的光谱。从左往右看,你的力气主要花在哪一段。
模型向左,不等于模型不重要
4 月写书 Skill 刚出来时,我在文章里提醒过读者:用它写书,始终用最新的 Claude 模型。
“模型是常量”说的是它对所有人都一样:你能买到的,别人也能买到。选哪个模型照样影响结果,只是它拉不开你和别人的差距。
所以有更便宜的新模型出来时,可以拿你积累的 Case 跑一遍。能过,就换过去;过不去,就留在原来更强的那一档。没有 Case,就只能凭感觉决定换不换。
Agent 走出屏幕以后
我在外滩大会上留下的第三个判断是:当 Agent 从屏幕进入身体和空间,Skill 会成为人的意图和机器行动之间的接口。同样的结构会出现在机器人、汽车、工厂、家庭和医疗辅助设备里。
人给出目标、判断、授权和责任边界,Skill 提供上下文、工作流、工具、权限和完成标准,机器把它变成现实世界的动作。
AI 越能改变现实世界,控制权和验收越重要:谁同意它做,做到什么程度算完成,出了问题谁负责。
常见误区
- —等下一个更强的模型再开始。涨上来的能力人人都有,你的 Context 还是空的。
- —给模型的短板写补丁,当成核心能力。我的 K 型压缩算法就是这样归零的。
- —以为模型强了,Skill 就没用了。视频流水线的第二次降本,靠的正是 Skill 里留下的判断和验收。
- —把 Skill 绑死在一个模型上。模型层要能换,Case 才能告诉你换完行不行。
- 第 1 题单选手工川为微信群总结机器人写的 K 型压缩算法,为什么一夜归零?
- 第 2 题单选视频流水线的成本第二次下降,降到约 2 元人民币/分钟,靠的是什么?
- 第 3 题判断“模型是常量”的意思是,选哪个模型对结果完全没有影响。
- 手工川《超越之旅》第一期讲义,第一章“模型是常量,Context 是变量”、第七章“从一条到一百条”
- 手工川《Skill 开发最佳实践与商业化探索》,2026 年支付宝外滩大会分享
- 手工川《Agent Skill 商业化三角不可能定理》,公众号「手工川」2026-04-20