K2为什么需要 Skill:经验不能只留在对话里
对话一结束,上下文就散了。Skill 把做法、材料和完成标准存进文件,下次照样做对,结果也能验收。
第五期创造营有一道全天最硬的门:你做出来的能力,必须存在于文件里,不能只存在于对话历史里。
对话历史会丢,文件不会。今天你和 AI 聊了三个小时,终于把一件事做对了;如果这三个小时只存在于聊天记录里,下次你还得从头再聊一遍。
只靠对话,同样的代价会反复出现
对话结束,上下文就散了。下次遇到同样的问题,下面三件事会再来一遍:
Skill 把流程、工具和完成标准固定下来。固定下来,结果才能验证,这份能力也才能被安装、分发和定价。
模型越强,越需要告诉它往哪看
大模型本身已经很强,强到它默认会给你一个“平均水平”的答案。你让它写一篇关于 AI 的文章,它会给你结构正确、用词得体、事实大体不错的一篇,读起来却没有你自己的东西。它不知道你想要什么,默认在对着全人类讲话。
Skill 的作用,不是教模型新知识——模型早就知道了。Skill 的作用是告诉它:「你看这边,别看那边。」
我把过去两年的 199 篇公众号原文提炼成书的时候,反复在白板上写一句话:模型是常量,Context 是变量。模型谁都能买到,拉开差距的是你给它的上下文,比如你的目录、你的资料、你上次的判据、你们公司的黑话。Skill 把这些写进文件,遇到这类任务就自动带上。
我一年的 1,852 次调用,花在了哪里
2026 年 9 月去支付宝外滩大会分享之前,我把过去一年的 AI 使用记录翻了个底朝天:扫描了 3,195 份 Claude Code 和 Codex 的会话记录,确认出 1,852 次 Skill 调用。我每个月在 AI 上花大约 300 美金,写文章、剪视频、做产品、办活动都写了 Skill,所以这份调用记录,基本就是我这一年的工作日志。
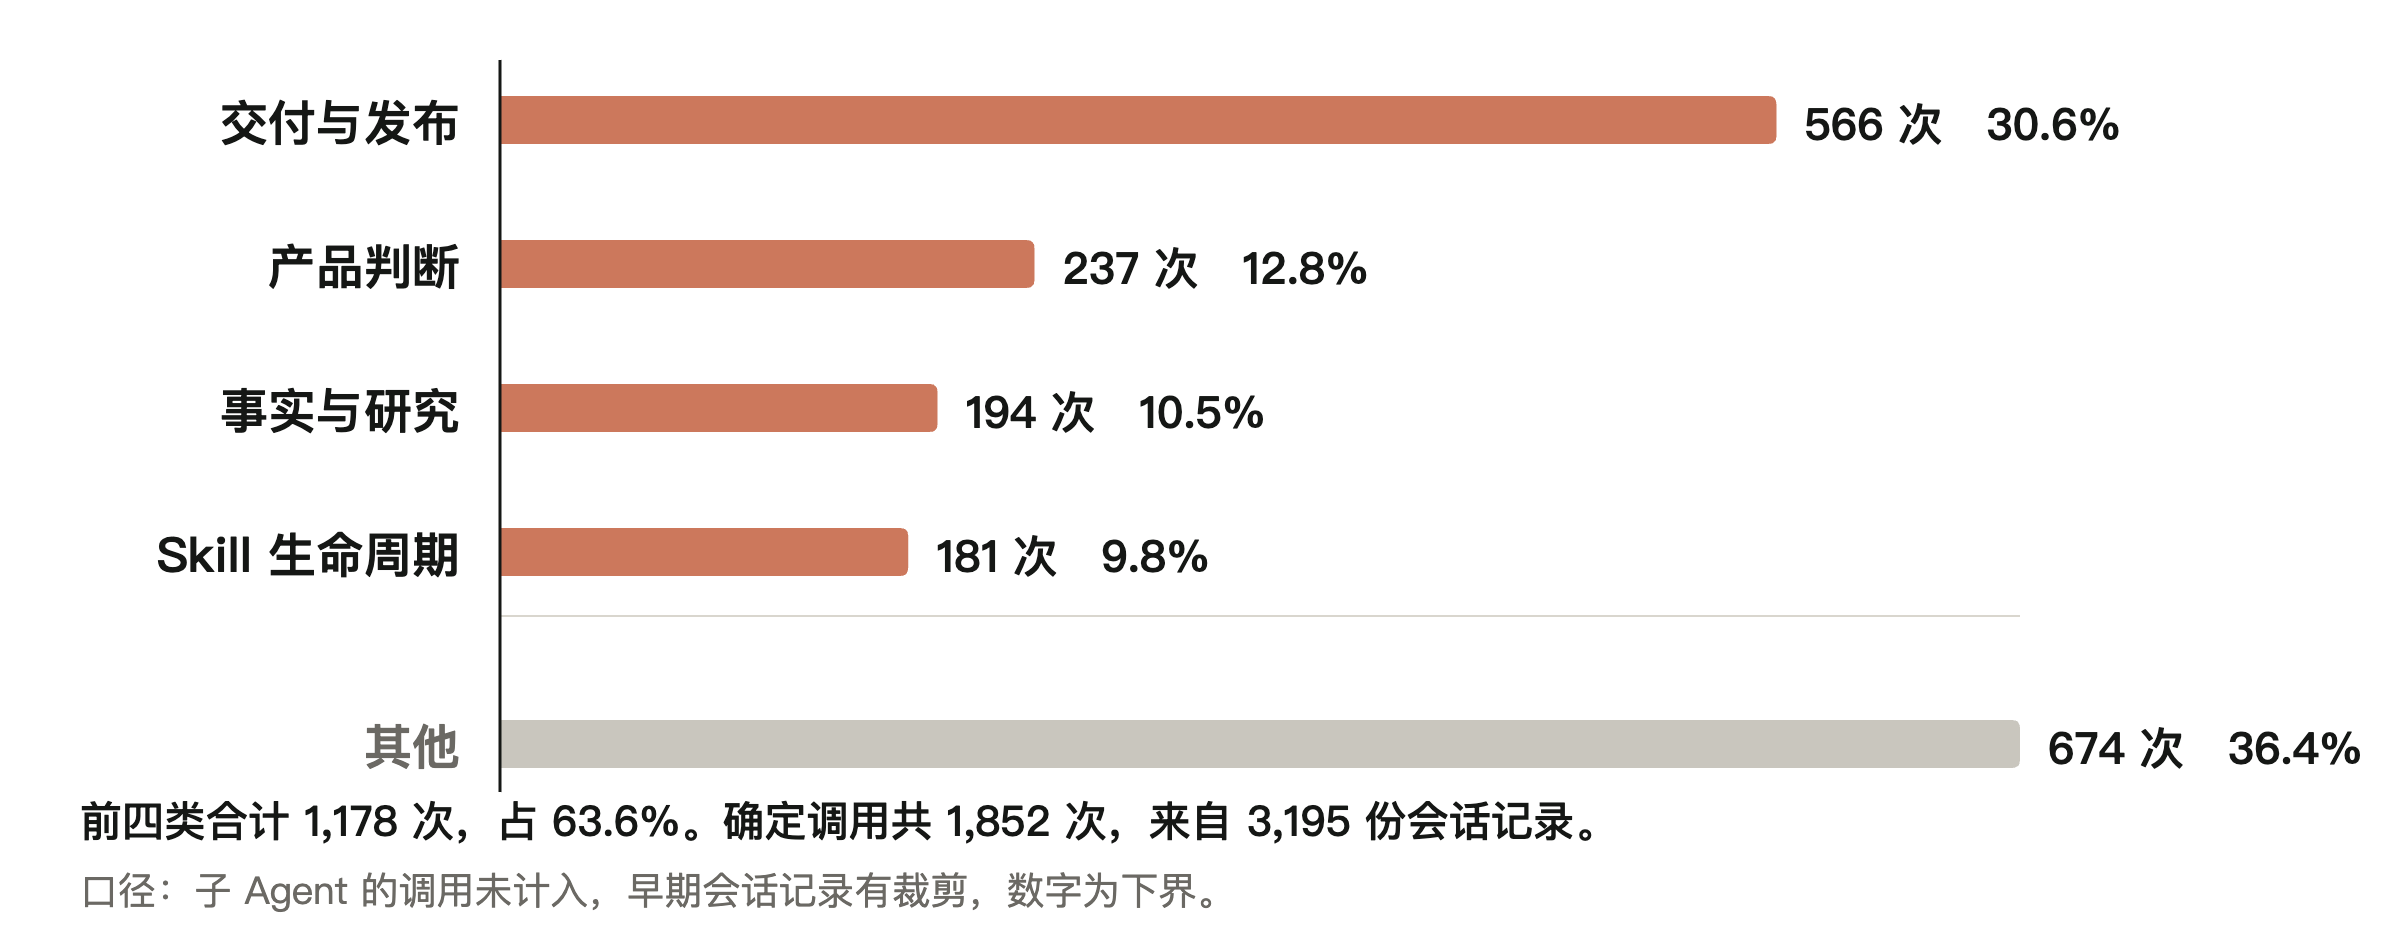
排第一的是 Git Commit,也就是把改好的东西提交保存,401 次;第二是发布上线,165 次;第三是事实核查,130 次。按类别算,交付与发布 566 次,产品判断 237 次,事实与研究 194 次,Skill 生命周期 181 次,四类合计 1,178 次,占 63.6%。
我用 AI 最多的地方,是交付、判断和查证,而不是生成。写出来只是第一步。写得对不对、能不能发出去、发出去之后能不能找回来,才是真正花时间的地方,也最需要一份写下来的做法和完成标准。
沉淀成 Skill,成本会掉下来
外滩大会上我还讲过一个媒体生产的案例:一条视频,由三个 Skill 前后接力做完。
成本下降了两次。第一次是把工作流沉淀成 Skill,每分钟的成本从 100 美元降到 5 美元;第二次是保留人的判断和验收,把执行的模型换成低成本模型,降到约 2 元人民币。
对一个人的公司,Skill 是能交付的资产
2026 年 5 月在浦东的 OPC 企业座谈会上,我说自己今年押注两个方向:产品的 Skill 化,和 Skill 的产品化。前者是把过去要在一整套界面里点来点去的流程,压缩成 AI 可以直接执行的任务,用户只要说一句“帮我报销这张发票”;后者是把一个跑得通的 Skill,封装成普通客户能买、能用、能复购的服务。
这两件事都要求你的做法已经写成文件,并且被真实任务验收过。
常见误区
- —模型越来越强,就不用写 Skill 了。模型越强,越会给你一个面面俱到的平均答案,越需要你告诉它往哪里看。
- —Skill 是程序员的事。写文章、剪视频、做产品、办活动,我都给自己写了 Skill。
- —写一次就一劳永逸。那 1,852 次调用里,有 181 次花在 Skill 生命周期上,处理的是 Skill 本身;工作方式变了,Skill 也得跟着改。
- 第 1 题单选我那 1,852 次 Skill 调用里,排第一的是哪一个?
- 第 2 题多选(选出全部正确项)只靠对话、不把做法沉淀成 Skill,会反复付出哪些代价?
- 第 3 题判断视频流水线的成本第二次下降,是因为把人的判断和验收也交给了低成本模型。
- 手工川《Skill 开发最佳实践与商业化探索》,2026 年支付宝外滩大会分享
- 手工川在浦东新区 OPC 企业座谈会上的发言,上海2026-05-19