H7如何打磨自己的 Agent Harness
从被绊倒的地方改起:先查是哪一层的问题,能检查的不写成提醒,反馈写进最窄的一层,关掉电脑明天还在。
第五期创造营开课之前,我给 DeepSeek Harness 写了七个插件,都发布在 npm 上,名字统一以 @lovstudio/dsh- 开头。
| 插件 | 我被绊了一下的地方 |
|---|---|
dsh-account-balance | 额度还剩多少,看不见 |
dsh-better-command | 斜杠命令记不住全名 |
dsh-better-restart | 改完配置要重开 |
dsh-plugin-marketplace | 找不到别人写的插件 |
dsh-inject-system-prompt | 每次都要重复交代我的规矩 |
dsh-llm-config | 模型配置到处抄 |
dsh-frontend-inspector | 点了页面,找不到源码在哪 |
七个插件,七块石头
没有一个是“我想做个 AI 功能”,全是干活时被绊了一下,回头把那块石头搬走。打磨 harness 也从这里开始:这一周,哪件事让你烦了第三次?
先查是哪一层出了问题
Agent 表现不好,很多人的第一反应是换一个更强的模型。我会先把工作台拆成四层,看问题出在哪一层。
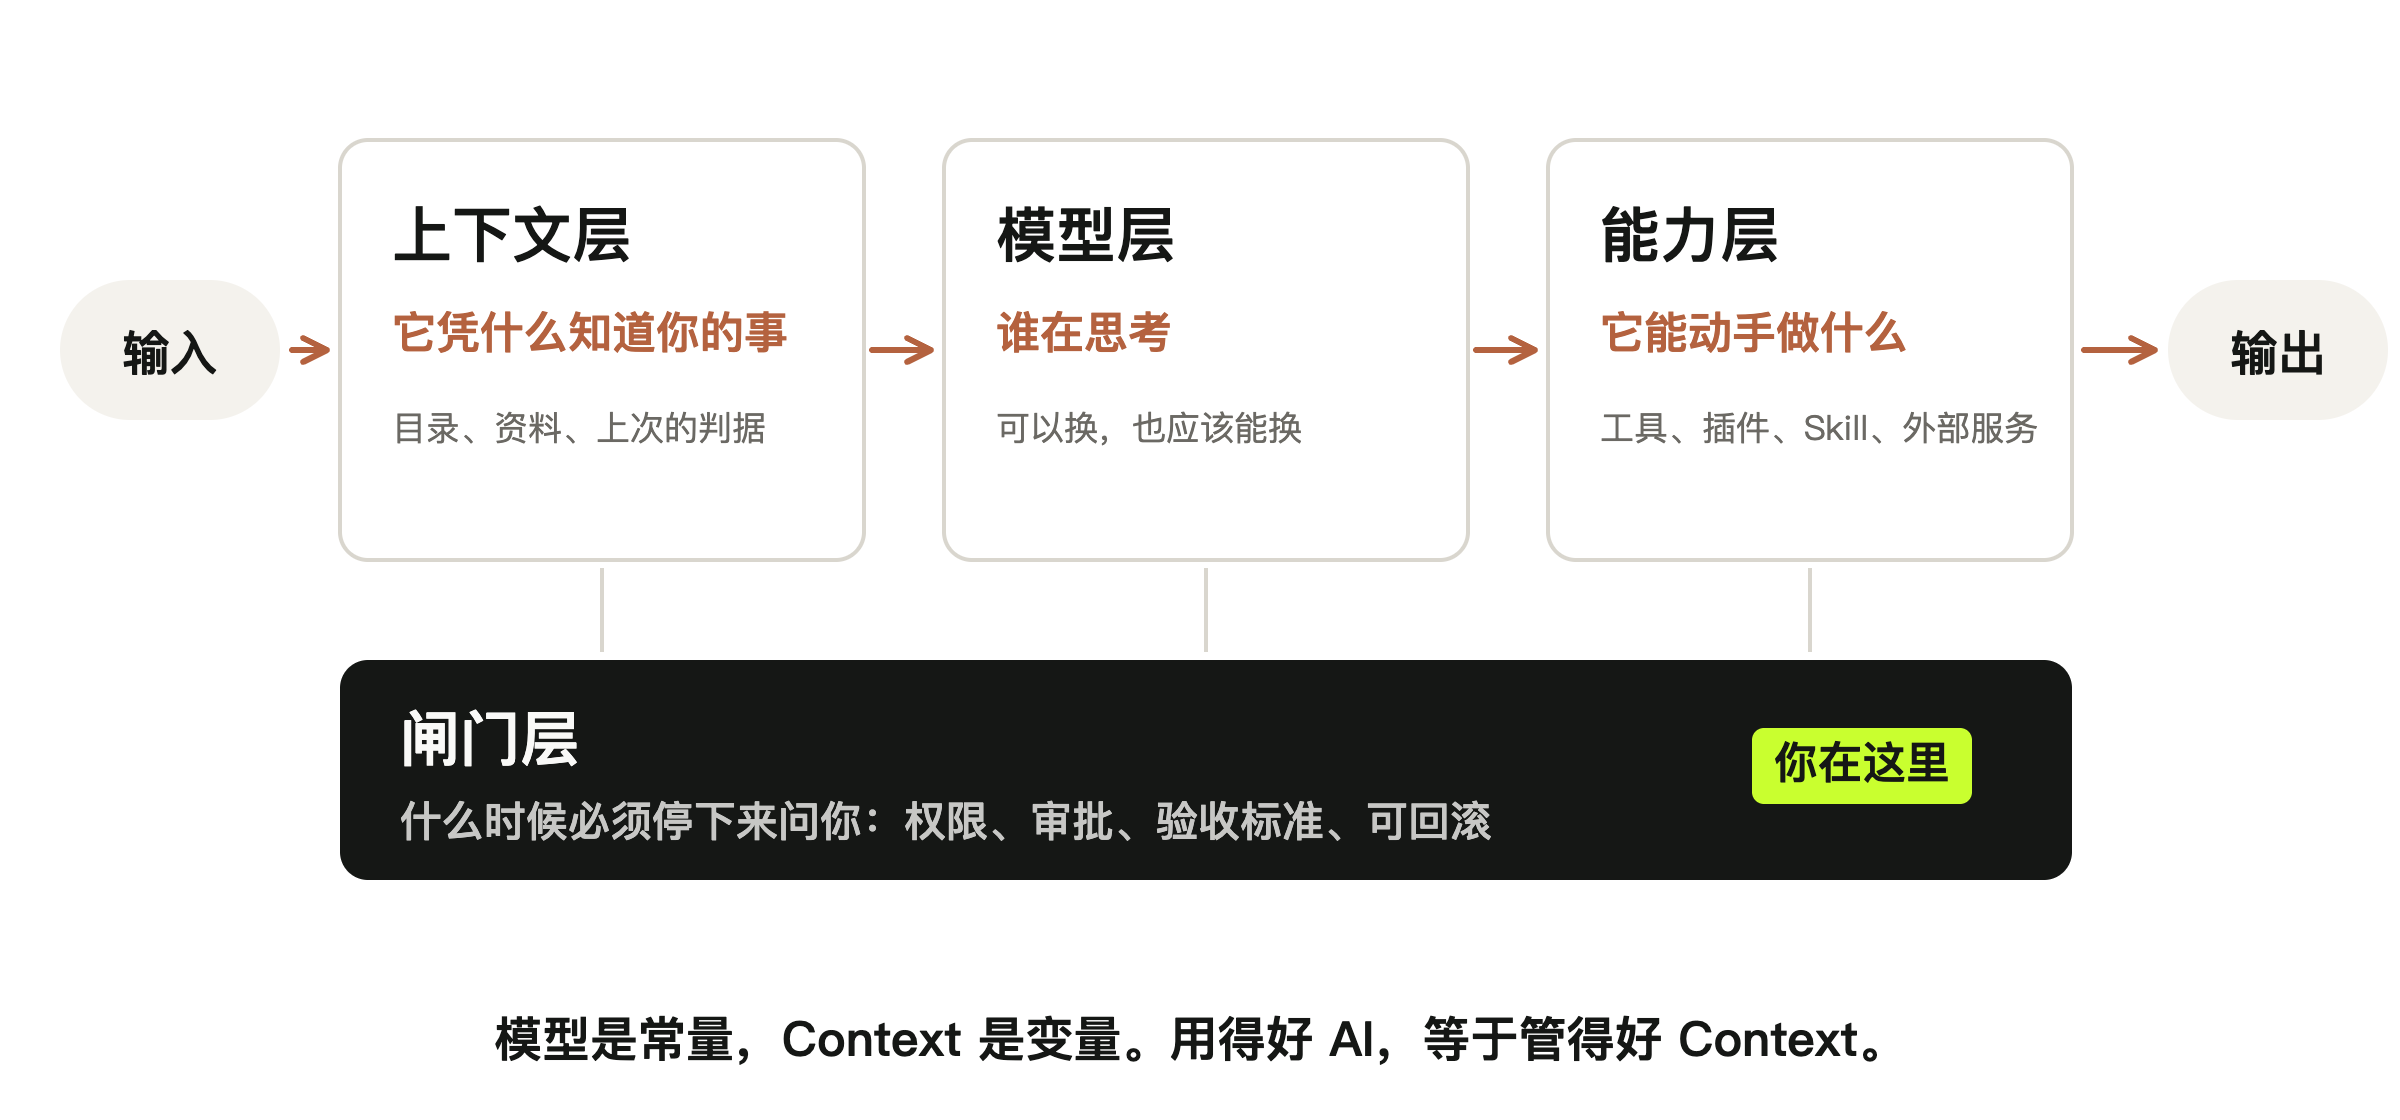
- —上下文层:它凭什么知道你的事。你的目录、资料、上次的判据。
- —模型层:谁在思考。可以换,也应该能换。
- —能力层:它能动手做什么。工具、插件、Skill、外部服务。
- —闸门层:什么时候必须停下来问你。权限、审批、验收标准、可回滚。
模型是所有人都能买到的,真正拉开差距的是上下文层和闸门层:前者决定它懂不懂你,后者决定你敢不敢把事交给它。定位的时候,先看 harness 实际加载了什么。一个被遗忘的全局 hook、一份过期的 memory 文件、一个没启用的 skill,都可能让 Agent 看起来“变笨了”,Yoda 的 Harness 观测面板就是为这一步做的。
能写成检查的,就别写成提醒
跟 Agent 说“记得写测试”,基本没用;在 CI 里加一个覆盖率门槛,不达标就失败,立刻有效。提醒会被越来越长的上下文稀释,检查不会。
我在这件事上吃过一次很具体的亏。2026 年 9 月 2 日,我让 Agent 把“禁止编造”写进一个 Skill,同一次会话的下一轮,它就违反了。当天我就写了一个 Stop Hook。Agent 每次准备结束,它就扫一遍会话记录,凡是路径、提交号这类具体信息,没在之前的工具输出或我的消息里出现过,就标出来。
提示层的「禁止编造」约束对幻觉无效……需要机械门禁而非规则条文。
Stop Hook 能做的不止这一件。Agent 准备结束时,它可以跑检查脚本、跑测试、看 diff,甚至叫另一个 Agent 来 review,没通过就让它接着修。“完成”要经过外部验收才算数。
Harness 会越写越厚
我以前的做法是:遇到一次错误,就往 AGENTS.md 里补一条;发现 Agent 忘了测试,就在 system prompt 里再强调一遍;换一个项目,把攒下的整套规则复制过去。harness 确实越来越强,也越来越厚。直到有一天,打开那份几千上万字的说明,我已经很难回答:这里面有多少条跟眼前这个任务有关?
规则多了并不更安全。无关的上下文会抢注意力,重复的规则制造噪声,互相冲突的规则让 Agent 在一份看似严谨的说明里左右横跳。
Yoda 里的原子原则是我对这件事的一次尝试。它把一份大 prompt 拆成一条条独立、可命名、可开关的运行原则,比如“修改后必须运行测试”“禁止直接修改数据库迁移”“面向用户的回复使用中文”。创建任务时它们以开关的形式出现,全局给默认值,进了项目可以单独开关,只有开着的那几条,会在会话启动时拼到客户端的 system prompt 后面。
CLAUDE.md 也是一样。我试过让 Claude 帮我生成一份,又长又泛,把项目里显而易见的东西说了一遍。后来手写了 40 行,效果好了不止一个档次。
还有一类 harness,模型一升级就会被抹平。2024 年上半年,我和团队在做一个微信群总结机器人,那时候模型的上下文窗口只有 8K,群聊记录塞不进去。我写了一个 K 型压缩算法:首尾多保留,中间压缩,递归压到 6K 以内。那是我们当时的核心技术。几个月后,上下文窗口从 8K 涨到了 200K,这门技术一夜之间归零。给模型补短板的那部分,要做好随时删掉的准备。
反馈写进最窄的那一层
我给自己所有的 Agent 写了一份全局规则,按“收到任务、理解任务、执行任务、交付与复盘、反馈与迭代”五段组织,每一条有固定编号。它用语义化版本管理:2026 年 8 月 29 日是 0.1.0,到 10 月 18 日已经是 0.26.0。每次行为变化都升版本、写更新日志,日志里附上触发这次修改的原话。
里面最要紧的一条是分层:只跟这一次任务有关的反馈,只改这一次的产物;能复用的,写进最窄的那个 Skill 或参考文件;跨领域都成立的原则,才去动全局规则。
| 反馈的范围 | 写到哪里 |
|---|---|
| 只跟这一次任务有关 | 当前产物 |
| 同一类任务都会遇到 | 对应的 Skill 或参考文件 |
| 跨领域都成立 | 全局规则:升版本、记原话 |
举个例子。语音转写默认用哪个服务,我前后纠正过 Agent 三次,因为这条约定只记在两个项目的记忆里,换个项目就失效。第三次之后,我把它从项目记忆挪进了全局的参考文件。
怎么算磨好了
第四期创造营结束两周后我回访,有人的东西还在用、还在长,有人的东西停在了那个周末,差别在于有没有留下一套还能接着用的东西。所以验收只有一条:关掉电脑,明天重新打开,一切还在。能力要存在文件里,按门槛从低到高是配置、Skill、插件或程序,对大多数人来说 Skill 的性价比最高。
| 级别 | 标准 |
|---|---|
| 一级 | 能在你自己的第二台电脑上装上并跑通 |
| 二级 | 你的同事或朋友能装上,并且在你不说话的情况下,跑出一次正确的结果 |
| 三级 | 打包上架,陌生人能搜到、装上、用起来 |
发布的三个级别
第五期的结营标准更直接:同一台工作台,用两个不同的真实输入各跑一次,都成立。只跑通一次的叫演示,跑通两次的才叫工作台。把上面这些串起来,就是我每次被绊倒之后走的一圈:
最常见的几个坑
- —把规则当保险。规则越堆越多,Agent 反而左右为难。
- —整套复制。把 A 项目的规矩原样搬进 B 项目,大半都是噪声。
- —让 AI 自动生成一份很长的
CLAUDE.md。又长又泛,占着上下文,却不提供约束。 - —只在模型层花钱。换了更贵的模型,上下文和闸门照旧是空的。
- —把工具建在你控制不了的东西上。如果下个版本的模型顺手做了这件事,或者账号明天登不上了,你的东西还在不在?
- 第 1 题单选Agent 反复违反写在 Skill 里的“禁止编造”规则,按手工川的做法,下一步该怎么办?
- 第 2 题判断Harness 写得越厚、规则越多,Agent 就越安全。
- 第 3 题多选(选出全部正确项)下面哪些可以作为“工作台磨好了”的验收标准?
- DeepSeek Harness 指南:Quickstart
- npm 上的 @lovstudio/dsh- 系列插件
- Yoda 文档(Harness 观测、自定义 Agent)
- 手工川《置身 OPC 内 | 深度》,“如何让 AI 跑得足够长”一节2026-07-08
- 手工川《Agent 时代,我们到底需要怎样的 IDE》,“Harness 进化”一节,公众号「手工川」2026-07-16
- 手工川《Harness Engineering 的四大问题》(CI 覆盖率门槛、手写 40 行 CLAUDE.md),公众号「手工川」2026-04-03
- 手工川《超越之旅》第一期讲义,第一章(工作台四层、K 型压缩算法)、第八章(七个插件、发布三级)