A6什么是 AI Agent:模型、工具和一个循环
AI Agent 是大模型在循环里使用工具:你给目标,它自己决定步骤,看反馈再调整,人站在循环之上。
8 点 50,签到表没打印出来
2026 年 4 月,手工川 AI 创造营第一期开课那天,早上 8 点 50,签到表没打印出来。
按老办法,我应该手忙脚乱地翻 Excel、贴桌签。那天我打开 Claude Code,说了一句:帮我做一个签到页,扫码就能上墙,每个人到了点一下名字,附一句自我介绍。然后我就去开门迎人了。
回来的时候,流程已经跑通。配色、后端、内网穿透这些技术活,都是它自己搞定的。第一节课还没开始,第一节课已经开始了。
我只给了一个目标。要写哪些文件、跑哪些命令、怎么让大家的手机扫得到,都是它自己决定的。这就是 AI Agent 和一个聊天框的分别。
一句话定义
Anthropic 在 2024 年 12 月发表的《Building effective agents》里,有一句我很喜欢的话:
Agent 通常就是大模型根据环境反馈,在一个循环里使用工具。
拆开看是三样东西。模型负责想;工具负责做,比如读写文件、执行命令、打开网页;循环负责“做完看结果,不对再改”。少了循环,它就是一次问答;少了工具,它只能说不能做。
工作流和 Agent 的分界
同一篇文章把这类系统分成两种。工作流用预先写好的代码路径,把模型和工具串起来;Agent 让模型自己动态决定流程和工具怎么用,自己掌控完成任务的方式。
| 你,一问一答 | 写死的代码路径 | 模型自己 | |
| 只能回答 | 按预设调用工具 | 自己选工具:读写文件、跑命令、开网页 | |
| 等你追问 | 走不下去,或报错退出 | 看反馈,换方案再试 | |
| 问答、写作、改稿 | 步骤固定、要求稳定的活 | 步骤事先说不清、要边做边判断的任务 |
- 谁决定下一步
- 你,一问一答
- 能不能动手
- 只能回答
- 遇到意外
- 等你追问
- 适合
- 问答、写作、改稿
Anthropic 的建议很实在:先找最简单的方案,只在确实需要时再加复杂度;很多场景里,把一次模型调用优化好就够了。这和 A1 讲的分诊是一个道理:步骤固定、要求稳定的,用工作流;步骤事先说不清、要边做边判断的,才值得交给 Agent。
一台 Agent 工作台的四层
我习惯把一台能持续干活的 Agent 工作台拆成四层:上下文层、模型层、能力层、闸门层。
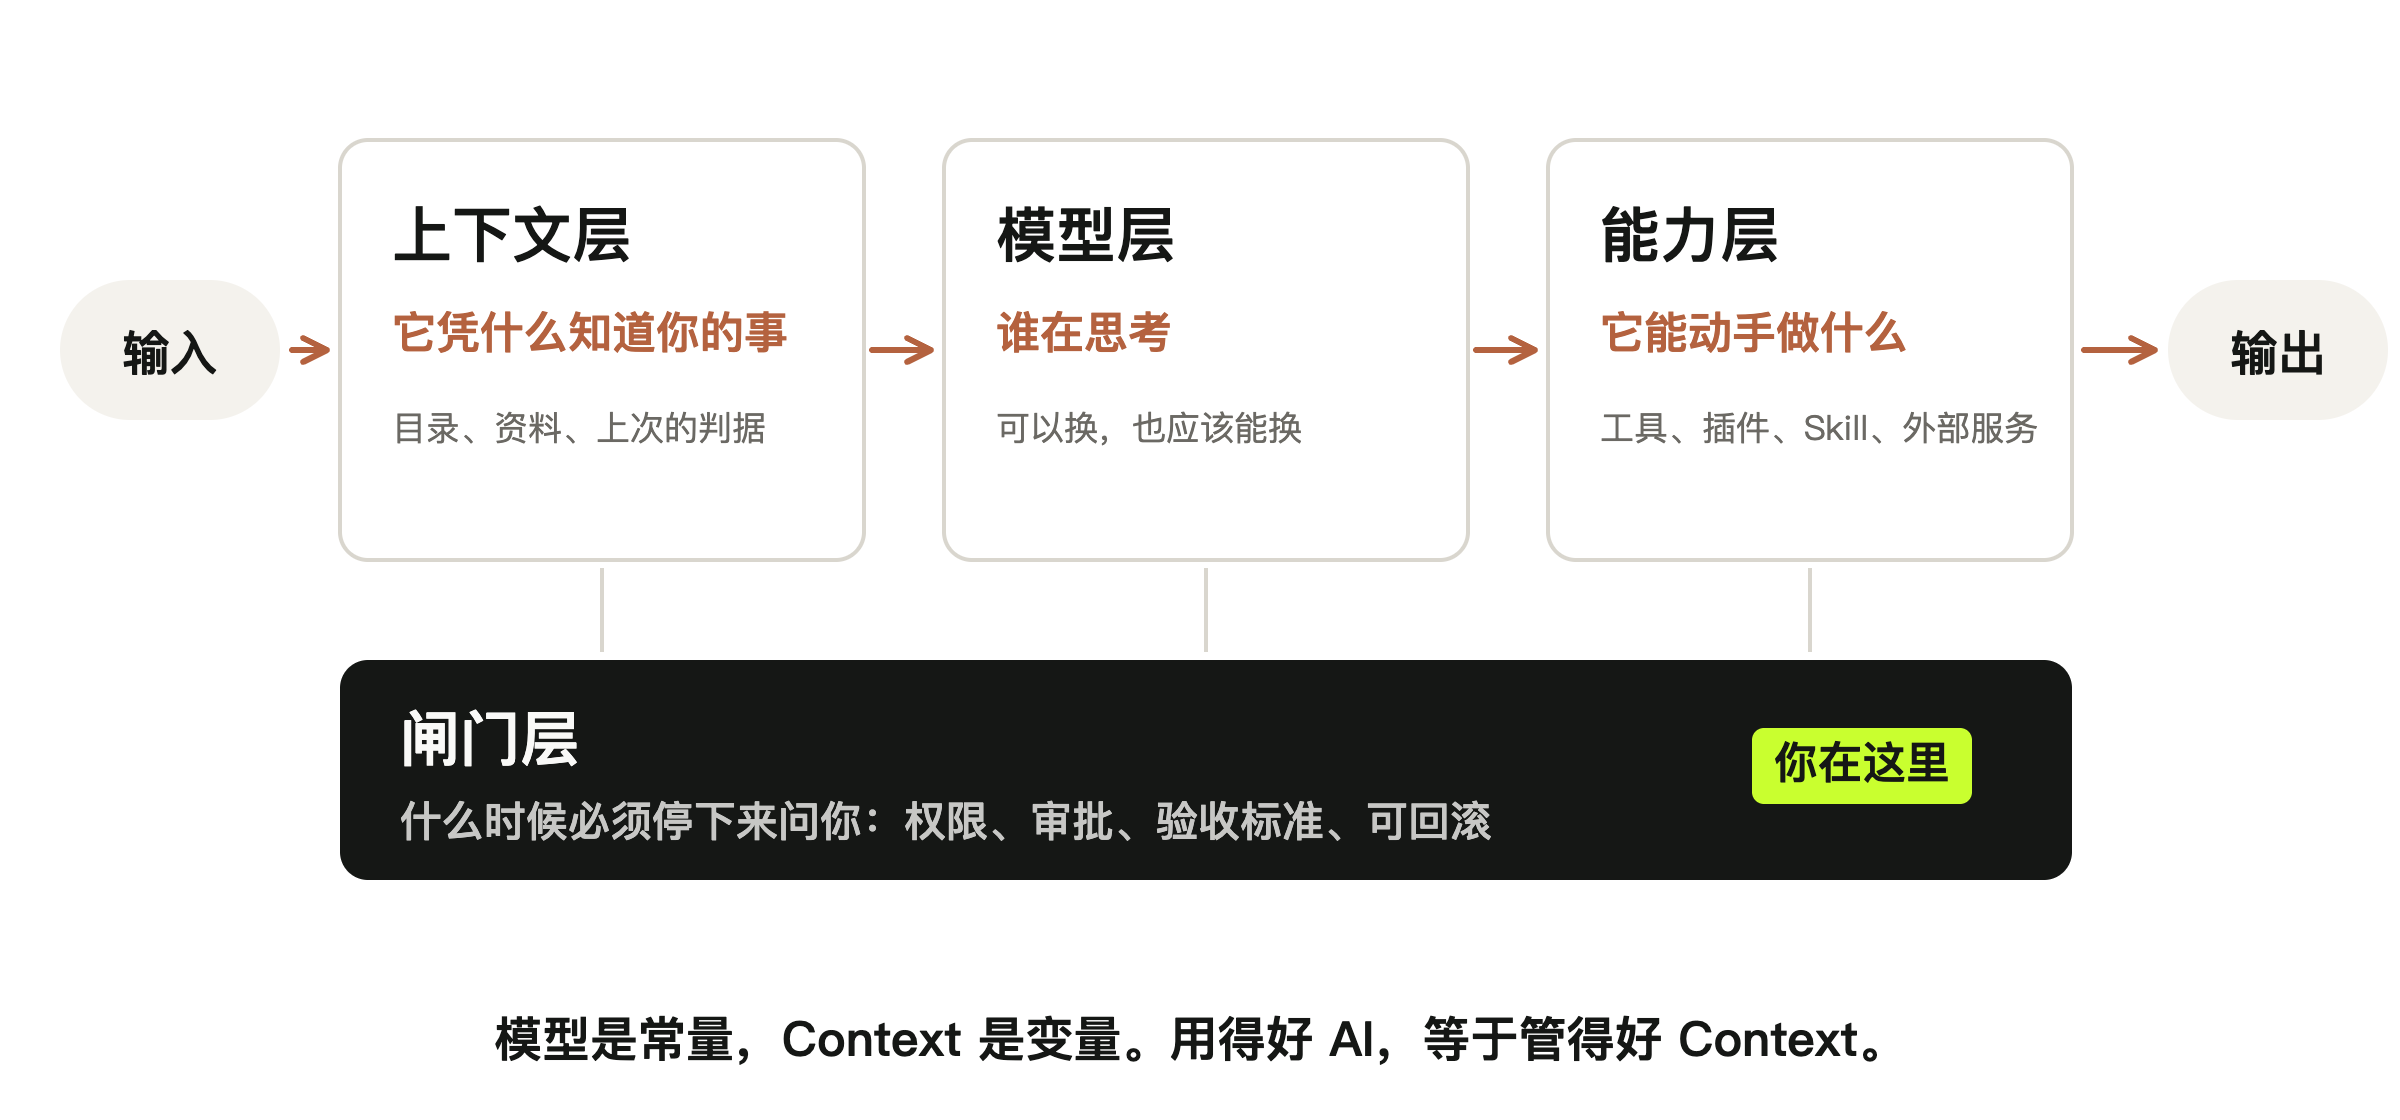
大部分人只在模型层上花心思:哪个模型最强,哪个最便宜。可模型是所有人都能买到的,真正拉开差距的是上下文层和闸门层,前者决定它懂不懂你,后者决定你敢不敢把事交给它。
把这几层装在一起的运行环境,有一个专门的名字叫 Harness,原意是马具。后面讲 Agent Harness 的部分会专门展开。
它会自己设循环,也会误解你
2026 年 4 月,我在准备第一期海报时迭代了小几十个版本。快要定稿的时候,Claude Code 自动压缩了一次上下文,注意力出现偏差,误以为我要重构设计。它给自己设了一个“设计、实现、审阅、再设计”的循环,几分钟后重构出一版让我震惊的成品,一次通过。
我盯着屏幕想:设计真的不存在了。可这件事也有另一面,它是在误解我的前提下动的手。那次是惊喜,换一个场景就可能是事故:第一期创造营的一位嘉宾讲过,他上台那天早上发现,前一晚的 PPT 被自己跑的某个 Agent 覆盖了,花了一个小时回滚版本才找回来。
三个常见误区
- —把 Agent 当函数。 丢进去,等结果。它是一个循环,你可以在任何一轮介入:方向错了就打断,卡住了就贴日志,它说完成了就让它跑一遍测试。
- —以为 Agent 越多越好。 一个人同时开三台车,不叫车队。多个 Agent 的价值在实现、审查、裁判的分工,关键是验收口径不同。
- —它说完成了,就当完成了。 在终点放一道检查:自动跑测试、看改动、让另一个 Agent 审一遍,没过就接着改。这类机制叫 Stop Hook。
- 第 1 题单选按 Anthropic《Building effective agents》,工作流和 Agent 的主要区别是什么?
- 第 2 题多选(选出全部正确项)本节的 Agent 工作台由哪几层组成?
- 第 3 题判断Anthropic 建议:做 AI 应用时先找最简单的方案,只在确实需要时再增加复杂度。
- Anthropic:Building effective agents2024-12-19
- Claude Code(GitHub)
- 手工川:《如何用 AI 制作视频》,B 站2026-10-21